Da coleta à entrega: como um pipeline de dados sustenta decisões de IA
-
por Mytech
-

5 min de leitura
-

12 de novembro, 2026

por Mytech
5 min de leitura
12 de novembro, 2026
Quando um modelo de IA devolve uma resposta estranha ou um indicador aparece diferente do esperado no relatório, o primeiro reflexo costuma ser olhar para o modelo ou para o dashboard. Na maior parte das vezes, o problema está bem antes disso.
Todo número que chega a uma tela é o último passo de um caminho que começou em algum sistema de origem e passou por coleta, armazenamento, transformação e validação. Esse caminho é o pipeline de dados. Ele é invisível quando funciona e é exatamente por isso que costuma ser o ponto menos discutido, e o mais determinante, em projetos de inteligência artificial.
Um pipeline de dados é o conjunto de etapas automatizadas que move os dados das fontes de origem até o destino onde serão consumidos, aplicando ao longo do caminho as transformações necessárias para que essa informação seja utilizável. É o que a AWS descreve como o mecanismo que conecta a coleta de dados brutos ao consumo analítico.
Vale uma distinção importante, porque ela explica boa parte dos projetos que travam: um pipeline não é a mesma coisa que um script de integração. Um script move dados de um ponto a outro quando alguém o executa. Um pipeline roda sozinho, respeita dependências entre etapas, avisa quando falha, registra o que foi processado e pode ser reexecutado sem gerar duplicidade. A diferença entre os dois é a diferença entre um processo que a empresa consegue auditar e um processo que depende de memória individual.
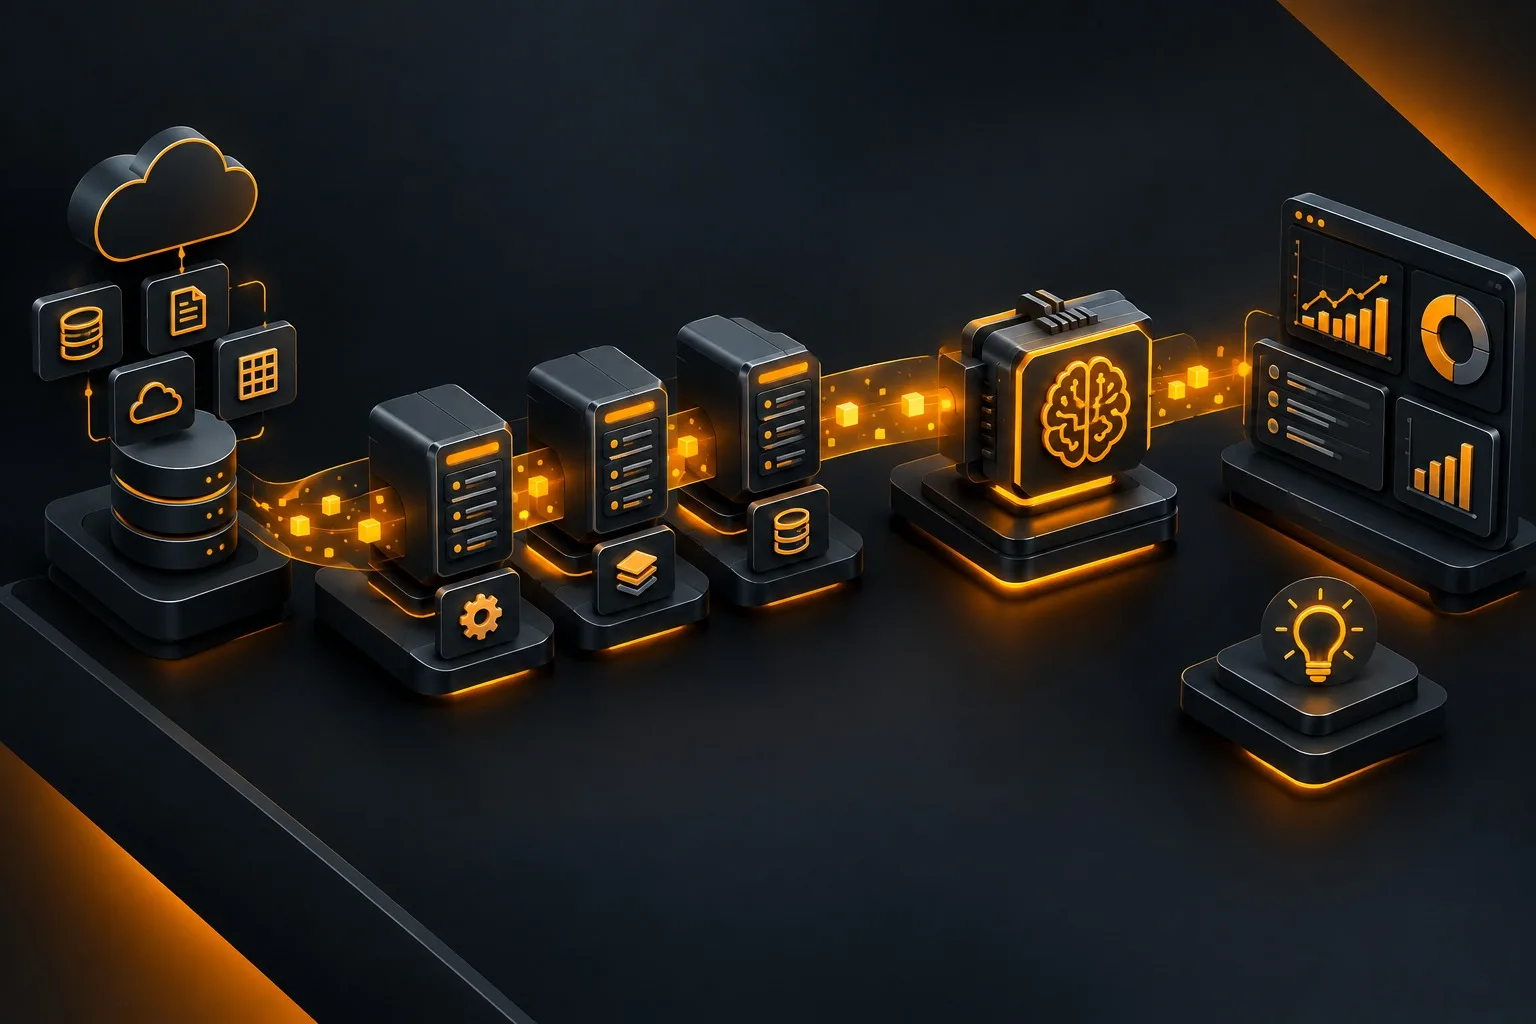
O desenho muda conforme o cenário, mas seis etapas aparecem em praticamente qualquer arquitetura moderna de dados.
É o ponto de entrada. Os dados vêm de ERPs, CRMs, bancos transacionais, aplicações internas, APIs de parceiros, arquivos e dispositivos conectados. Aqui se define também o ritmo: cargas em lote, em intervalos programados, ou ingestão contínua, quando a decisão depende de informação recente.
O erro mais comum nessa etapa é coletar tudo o que está disponível sem definir para que aquilo será usado. O resultado é um ambiente caro de manter e difícil de navegar, cheio de dados que ninguém consome.
Os dados coletados precisam de um destino antes de serem tratados. Na nuvem, isso normalmente significa um data lake para o dado bruto, um data warehouse para o dado modelado e pronto para análise, ou uma arquitetura de lakehouse que combina as duas abordagens.
Uma prática que evita retrabalho: preservar o dado bruto como ele chegou, mesmo depois de transformado. Quando uma regra de negócio muda ou um erro de transformação é descoberto meses depois, é possível reprocessar tudo a partir da origem em vez de negociar uma nova extração com o time dono do sistema.
É a etapa que converte dado bruto em dado utilizável: limpeza, remoção de duplicados, padronização de formatos e nomenclaturas, cruzamento entre fontes e aplicação das regras de negócio da empresa.
É também onde entra a escolha entre as abordagens de ETL e ELT, que define se a transformação acontece antes ou depois da carga no destino. Em ambientes serverless, essa etapa costuma ser executada por serviços gerenciados, como mostra a orientação da AWS sobre ETL sem servidor, sem infraestrutura dedicada para manter.
Orquestração é o que garante que cada etapa rode na ordem certa, no momento certo, e que uma falha no meio do caminho não passe despercebida. Envolve controle de dependências entre jobs, agendamento, tentativas automáticas de reexecução e alertas quando algo não conclui.
É a etapa mais negligenciada e a que mais separa um pipeline de um conjunto de rotinas soltas. Sem ela, a empresa só descobre que a carga falhou quando alguém estranha um número na reunião.
Antes de o dado ser disponibilizado, ele precisa passar por validações: campos obrigatórios preenchidos, volumes dentro do esperado, valores dentro de faixas plausíveis, chaves que realmente cruzam entre as fontes.
Junto disso, a camada de governança define quem acessa o quê, como o dado é protegido em repouso e em trânsito, onde cada informação está catalogada e qual é a linhagem de cada campo, ou seja, de qual origem ele veio e quais transformações sofreu no caminho. Esse conjunto conecta o projeto de dados diretamente à estratégia de segurança na nuvem da empresa e às exigências de rastreabilidade da LGPD.
O dado tratado precisa chegar a quem vai usá-lo, e cada consumidor tem uma necessidade diferente. Times de negócio consomem via dashboards e relatórios. Sistemas consomem via APIs e integrações. Modelos de machine learning consomem conjuntos de atributos preparados especificamente para treinamento e inferência.
Uma entrega bem feita não é apenas disponibilizar a tabela. É entregar o dado no formato, na granularidade e na frequência que aquele consumidor específico precisa, com documentação suficiente para que ele seja usado sem interpretação adivinhada.
Projetos de inteligência artificial fracassam com frequência por motivos que não têm nada a ver com o modelo escolhido. Quatro dependências explicam a maior parte dos casos.
O modelo não corrige o dado, ele aprende o erro. Inconsistências que um analista humano ignoraria por bom senso são incorporadas pelo modelo como padrão legítimo. Um campo de cadastro preenchido de três formas diferentes vira três segmentos distintos de cliente.
Retreinamento exige um fluxo estável, não um esforço pontual. Um modelo em produção precisa ser realimentado conforme o comportamento muda. Se os dados de treinamento vieram de uma extração manual feita uma vez, não existe caminho automatizado para atualizá-lo, e o desempenho se degrada silenciosamente. É por isso que a engenharia de dados é a base de qualquer iniciativa de IA, e não uma etapa preparatória que se encerra.
Decisão automática exige rastreabilidade. Quando um sistema aprova, recusa ou prioriza algo sozinho, a empresa precisa conseguir explicar com base em quê. Sem linhagem de dados, não há como reconstruir o caminho que levou àquela decisão, o que inviabiliza auditoria e correção.
IA generativa depende de curadoria, não só de volume. Aplicações que respondem com base na documentação interna da empresa refletem exatamente a qualidade e a organização daquela base. E o controle sobre quais dados podem ou não alimentar esses modelos precisa estar definido no pipeline, antes de o conteúdo chegar à camada de inteligência artificial.
Alguns sintomas indicam que a base ainda não está pronta, independentemente de quanto investimento já foi feito em ferramentas:
Nenhum desses pontos impede a empresa de operar. Todos eles impedem que ela automatize decisões com segurança.
A Mytech é especialista em soluções AWS e cloud, com mais de 70 profissionais certificados e mais de 320 clientes atendidos, e projeta ambientes de dados e analytics cobrindo o fluxo completo, da ingestão ao consumo.
Ingestão e armazenamento. As conexões com as fontes existentes são mapeadas e implementadas com cargas em lote ou contínuas, conforme a necessidade de cada caso de uso. O Amazon S3 sustenta a camada de data lake, enquanto bancos como Amazon RDS e Amazon Aurora seguem como fontes transacionais integradas ao fluxo.
Transformação serverless. Os jobs de tratamento e modelagem são construídos com AWS Glue e AWS Lambda, o que elimina a necessidade de manter servidores dedicados para processamento e mantém o custo proporcional ao uso real.
Catalogação e governança. O AWS Glue Data Catalog centraliza os metadados, permitindo que diferentes times encontrem e entendam os dados disponíveis sem depender de conhecimento informal. Sobre isso, são aplicadas políticas de acesso com IAM, criptografia em repouso e em trânsito e, quando o cenário exige, identificação automática de dados sensíveis com o Amazon Macie.
Entrega e análise. Para consulta, entram Amazon Athena e Amazon Redshift, incluindo a opção Redshift Serverless. Para visualização, Amazon QuickSight, Metabase ou Power BI, de forma que cada área acompanhe seus indicadores sem depender de solicitação a terceiros.
Camada de IA. Com o pipeline estável, a plataforma evolui para modelos de machine learning com o Amazon SageMaker, incluindo retreinamento automático conforme novos dados são ingeridos, e para aplicações de IA generativa e agêntica com Amazon Bedrock.
O objetivo desse desenho é direto: fazer com que o caminho entre o sistema de origem e a decisão seja automatizado, monitorado e auditável, para que a discussão sobre IA comece de uma base confiável em vez de terminar nela.
Se a sua empresa já identificou casos de uso de IA, mas esbarra em dados espalhados, cargas manuais ou falta de confiança nos números, o passo anterior é revisar o pipeline que sustenta tudo isso.